【基本思想】
基于单向置换构造伪随机生成器的方法有两种等价的构造方式:
- 间接构造:构造一个简单的伪随机生成器 $\{0,1\}^{n}\rightarrow \{0,1\}^{n+1}$,将长度为 $n$ 的随机种子扩展为长度为 $n+1$ 的伪随机串。然后结合标准伪随机生成器的扩展因子中的构造方法,将其扩展为任意多项式长度 $\mathrm{poly}(n)$ 比特的字符串。
- 直接构造:将间接构造的构造过程展开,直接构造一个能够输出任意多项式长度伪随机序列的生成器。这种展开后的构造不仅本身具有意义,同时也是后续基于单向置换集合构造伪随机生成器的基础。
【间接构造】
构造定理
根据标准伪随机生成器的扩展因子中的扩展因子正确性定理,如果能够将长度为 $n$ 的随机种子扩展为长度为 $n+1$ 的伪随机串的生成器,那么就可以进一步将其扩展为任意多项式长度 $\mathrm{poly}(n)$ 比特的字符串。
因此,只需要证明:如果单向置换存在,那么可以构造一个将 $n$ 位种子扩展为 $n+1$ 位伪随机输出的生成器。
Theorem:设 $f$ 是长度保持的强单向函数,$b$ 是 $f$ 的硬核谓词,则由:
定义的算法 $G$ 是一个伪随机生成器。其中,$\cdot$ 表示字符串连接。
由于 $f$ 是长度保持函数,因此 $|f(s)|=|s|$,同时 $b$ 是 $f$ 的硬核谓词,有 $|b(s)|=1$,故有:
因此该生成器 $G$ 能够将 $n$ 位种子扩展为 $n+1$ 位输出
该构造实际上由两部分组成:
- $f(s)$:由于 $f$ 是单向置换,因此 $f(U_n)$ 类似随机字符串
- $b(s)$:虽然只有 $1$ 比特,但是它满足
- 如果知道 $s$,可以计算
- 如果只知道 $f(s)$,无法预测
因此,如果攻击者能够区分 $f(U_n)\cdot b(U_n)$ 和真正的随机串 $U_{n+1}$,那么说明攻击者能够利用 $f(U_n)$ 预测 $b(U_n)$,这就违反了硬核谓词的安全性质。
证明方式一
证明目标是证明 $\{G(U_n)\}_{n\in N}$ 是伪随机的,第一种证明方式利用多项式时间不可预测性证明伪随机性,只需要证明 $\{G(U_n)\}_{n\in N}$ 在多项式时间内不可预测即可。
反证假设
采用反证法。
假设存在一个有效算法 $A$,输入 $(1^{n+1},G(U_n))$,读取 $G(U_n)$ 的一个前缀并预测下一位。记 $\mathrm{next}_A(G(U_n))$,并且预测成功概率比随机猜测 $\frac{1}{2}$ 高出不可忽略的优势,即存在某个正多项式 $\mathrm{poly}(n)$,使得对于无限多个 $n$,有:
根据构造 $G(s)=f(s)\cdot b(s)$,$G(U_n)$ 的长度为 $n+1$,其中前 $n$ 位为 $f(U_n)$,最后 $1$ 位为 $b(U_n)$。
又由于 $f$ 是长度保持的强单向函数,因此 $f(U_n)$ 仍然是在 $\{0,1\}^{n}$ 上的均匀分布,故前 $n$ 位 $f(U_n)$ 完全随机,任何算法预测其中某一位的成功概率最多为 $\frac{1}{2}$,此时如果只需要达到 $\frac{1}{2}$ 的成功概率,那么使用随机选择即可实现。
而 $b$ 是 $f$ 的硬核谓词,攻击者只知道 $f(U_n)$,不知道原始输入 $U_n$,因此 $b(U_n)$ 不能由 $f(U_n)$ 在多项式时间内预测。所以,如果算法 $A$ 能够超过 $\frac12$ 的区分优势,那么这个优势只能来自预测 $G(U_n)$ 的最后一位,即 $b(U_n)$。
因此,为不失一般性,假设算法 $A$ 总是尝试预测 $G(U_n)$ 的最后一位,即第 $n+1$ 位。
预测最后一位
基于原算法 $A$,构造新算法 $A’$,该算法输入 $(1^{n+1},\alpha),\alpha\in\{0,1\}^{n+1}$,模拟 $A$ 的执行。但是,该算法 $A’$ 始终读取 $\alpha$ 的前 $n$ 位,永远不读取最后一位。
在模拟过程中,会出现以下三种情况:
- 情况 1:如果 $A$ 尝试预测 $\alpha$ 前 $n$ 位中的某一位,则 $A’$ 随机输出一个比特,由于前 $n$ 位均匀随机,所以成功概率为 $\frac12$
- 情况 2:如果 $A$ 尝试预测 $\alpha$ 最后一位,则 $A’$ 直接输出 $A$ 得到的预测结果
- 情况 3:如果 $A$ 试图读取 $\alpha$ 的所有比特,则 $A’$ 随机输出一个比特,此时成功概率为 $\frac12$
而由于 $A’$ 永远不会读取 $\alpha$ 最后一位,因此对于情况 1 和情况 3,原算法 $A$ 的成功概率最多为 $\frac12$,新算法 $A’$ 的成功概率也为 $\frac12$;对于情况 2,$A’$ 保持 $A$ 的预测能力,总体成功概率不会低于 $A$
所以可以直接假设 $A$ 总是预测最后一位,即直接令:
矛盾推出
现在,利用 $A$ 预测 $b(U_n)$,已知 $G(x)=f(x)\cdot b(x)$,所以在输入 $(1^{n+1},f(x)\cdot b(x))$ 时,算法 $A$ 读取 $f(x)$ 之后,预测最后一位 $b(x)$。而由于 $A$ 不会读取最后一位,所以它实际上只利用 $f(x)$ 预测 $b(x)$。因此,如果 $A$ 存在,那么就可以根据 $f(U_n)$ 预测 $b(U_n)$
为了形式化上述过程,定义算法 $A’’$,其输入 $y=f(x),x\in\{0,1\}^{n}$,该算法调用 $A$,输入 $(1^{n+1},y\cdot0)$,输出 $A$ 的输出。
由于 $A$ 永远不会读取最后一位,因此算法行为与最后一位无关,即有:
又因为 $A$ 总是预测最后一位,所以:
即有:
这意味着,存在一个多项式时间算法 $A’’$,可以根据 $f(U_n)$ 以不可忽略优势预测 $b(U_n)$。
但是,$b$ 是 $f$ 的硬核谓词,任何多项式时间算法都无法做到这一点。存在矛盾,因此不存在算法 $A$ 能够预测 $G(U_n)$ 的下一位。
所以 $\{G(U_n)\}_{n\in\mathbb{N}}$ 在多项式时间内不可预测,$G$ 是伪随机生成器。
证明方式二
证明目标是证明 $\{G(U_n)\}_{n\in N}$ 是伪随机的,而 $G(U_n)=f(U_n)\cdot b(U_n)$,因此只需要证明两个概率系综 $\{G(U_n)\}_{n\in \mathbb{N}}$ 和 $\{U_{n+1}\}_{n\in \mathbb{N}}$ 在多项式时间内不可区分即可,即证明不存在多项式时间算法能够区分 $G(U_n)$ 和真正随机的 $n+1$ 位随机串。
系综构造
根据构造 $G(s)=f(s)\cdot b(s)$,$G(U_n)$ 的长度为 $n+1$,其中前 $n$ 位为 $f(U_n)$,最后 $1$ 位为 $b(U_n)$。又由于 $f$ 是长度保持的强单向函数,因此 $f(U_n)$ 仍然是在 $\{0,1\}^{n}$ 上的均匀分布,故前 $n$ 位 $f(U_n)$ 完全随机
定义硬核谓词的取反为:
用系综 $E^{(1)}_n,E^{(2)}_n$ 分别表示 $\{G(U_n)\}_{n\in\mathbb N}$ 和 $\{G(U_n)\}_{n\in\mathbb N}$ 中硬核谓词取反,即:
区分优势
均匀概率系综 $\{U_{n+1}\}_{n\in \mathbb{N}}$ 可表示为:$f(U_n)\cdot U_1$,由于 $U_1$ 完全随机,$b(U_n)$ 和 $\bar b(U_n)$ 正好构成两个互补比特,因此 $f(U_n)\cdot U_1$ 等价于以 $\frac12$ 的概率分别选择 $f(U_n)\cdot b(U_n)$ 和 $f(U_n)\cdot \bar b(U_n)$
也就是说,$U_{n+1}$ 等价于随机选择 $E^{(1)}$ 或者 $E^{(2)}$,因此,对于任意区分器 $D$,有:
此时,$G(U_n)$ 与 $U_{n+1}$ 的区分优势为:
因此,如果 $D$ 能够区分 $G(U_n)$ 和 $U_{n+1}$,那么它一定能够区分 $E^{(1)}_n$ 和 $E^{(2)}_n$。所以,只需要证明 $E^{(1)}_n$ 和 $E^{(2)}_n$ 不可区分即可。
反证假设
假设存在多项式时间算法 $D$ 能够区分 $E^{(1)}_n$ 和 $E^{(2)}_n$,即存在多项式 $\mathrm{poly}(n)$,对于无限多个 $n$ 有:
进一步,利用 $D$ 构造一个预测算法 $A$,根据 $f(U_n)$ 预测 $b(U_n)$,该算法输入 $y=f(x),x\in\{0,1\}^{n}$,执行如下步骤:
- 随机猜测最后一位,即随机选择 $\sigma\in\{0,1\}$
- 运行 $D(y\cdot\sigma)$,如果 $D(y\cdot\sigma)=1$ 则输出 $\sigma$,否则输出 $1-\sigma$
也就是说,如果 $D$ 判断 $y\cdot\sigma$ 更像 $E^{(1)}_n$,那么认为 $\sigma=b(x)$,否则认为 $\sigma$ 是错误的,就输出 $1-\sigma=\overline{b}(x)$
成功概率
设 $U_1$ 表示算法第一步随机选择的 $\sigma$,且 $U_1$ 与 $U_n$ 独立。如果 $U_1=b(U_n)$,即随机选择的比特正好是真实值,此时算法需要:
如果 $U_1\neq b(U_n)$,即随机选择的比特是非真实值 $1-U_1=b(U_n)$,此时算法需要:
那么两种情况成功的概率和可记为:
当 $U_1=b(U_n)$ 时,输入 $f(U_n)\cdot b(U_n)$;当 $U_1\neq b(U_n)$ 时,输入 $f(U_n)\cdot\bar b(U_n)$,因此:
根据反证假设,有:
矛盾推出
上式意味着,存在一个多项式时间算法 $A$,能够根据 $f(U_n)$ 预测 $b(U_n)$,并且预测优势 $\frac{1}{2\mathrm{poly}(n)}$ 是不可忽略的。
但是,根据 $b$ 是 $f$ 的硬核谓词,而硬核谓词的定义要求,任何多项式时间算法都不能从 $f(U_n)$ 预测 $b(U_n)$ 超过随机猜测 $\frac12$ 的不可忽略优势。
存在矛盾。因此,不存在区分器 $D$ 可以区分 $E^{(1)}_n$ 和 $E^{(2)}_n$。进一步可得出,不存在算法可以区分 $G(U_n)$ 和 $U_{n+1}$。
所以,$G$ 是伪随机生成器。
【直接构造】
构造
前面的构造定理证明了,通过长度保持的强单向函数和对应的硬核谓词,可以构造一个将 $n$ 位种子扩展为 $n+1$ 位伪随机输出的生成器。结合标准伪随机生成器的扩展因子中的构造方法,可以进一步构造任意多项式扩展长度的伪随机生成器。
那么,将构造定理和构造方法的组合过程展开,可以直接给出一个新的构造。
Construction:若函数 $f:\{0,1\}^{*}\rightarrow \{0,1\}^{*}$ 是可在多项式时间计算的长度保持的强单向函数,$b:\{0,1\}^{*}\rightarrow \{0,1\}$ 是多项式时间可计算谓词,对于任意多项式 $\mathrm{poly}(n)>n$,输入 $s$,令 $s_0=s$,并设 $n=|s|$,对于 $1\leq j\leq \mathrm{poly}(|s|)$,执行
可得到伪随机生成器:
该构造从 $s_0$ 开始不断进行迭代,每一步输出一个比特 $\sigma_j$,最终得到 $\mathrm{poly}(n)$ 位输出 $\sigma_1\sigma_2\cdots\sigma_{\mathrm{poly}(n)}$,构造过程如下图所示。
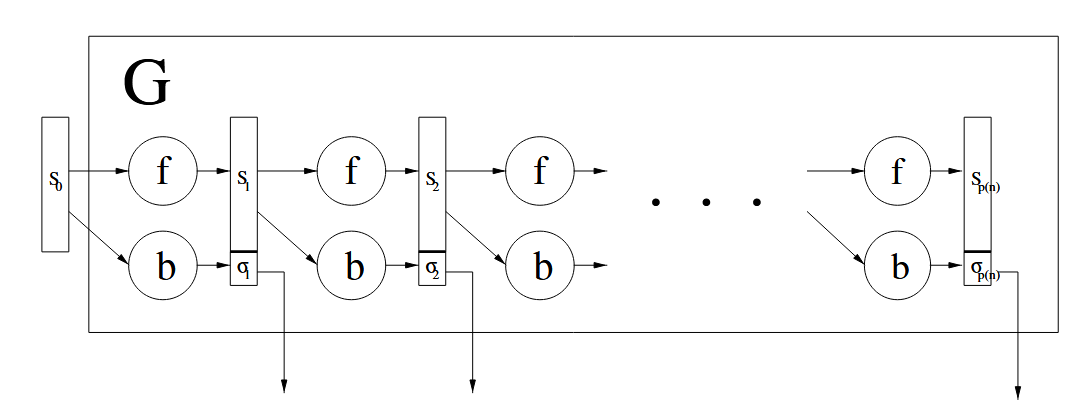
对于每一步 $\sigma_j=b(s_{j-1})$ 来说,如果知道 $s_{j-1}$,那么 $\sigma_j$ 就可以直接计算,但是攻击者只能看到 $s_j=f(s_{j-1})$。因此,如果 $b$ 是 $f$ 的硬核谓词,那么给定 $s_j=f(s_{j-1})$ 是无法对 $b(s_{j-1})$ 进行高效预测的。也就是说,每一个输出比特 $\sigma_j$ 对于攻击者而言都是不可预测的。
该生成器的安全性依赖于 $G$ 不输出 $s_j$,如果输出 $s_1,s_2,\cdots,s_j$,那么攻击者可以直接计算 $b(s_j)$。因此,其只输出 $\sigma_1,\sigma_2,\cdots,\sigma_{\mathrm{poly}(n)}$,隐藏 $s_1,s_2,\cdots,s_{\mathrm{poly}(n)}$
构造命题
Proposition:设 $f,b,G$ 与上述构造同构,若 $b$ 是 $f$ 的硬核谓词,那么 $G$ 是一个伪随机生成器。
证明
基本思路
定义一个新的生成器 $G’$,它将 $G$ 输出的比特顺序反转,即若:
则:
令 $t=\mathrm{poly}(n)$,对于 $j<t$,有:
其中,$f^0(s)=s$,并且 $f^{i+1}(s)=f(f^i(s))$。因此,$G’(s)$ 的第 $j$ 位为 $b(f^{t-j}(s))$,即第 $j$ 位对应 $G(s)$ 中的第 $t-j+1$ 位。
由于只是改变比特顺序,所以当且仅当 $\{G’(U_n)\}$ 是伪随机时,$\{G(U_n)\}$ 是伪随机。因此,只需要证明 $G’$ 是伪随机即可。
根据标准伪随机生成器的扩展因子中的伪随机性的等价定理,只需要证明 $\{G’(U_n)\}$ 在多项式时间内不可预测,即可等价证明 $G$ 是一个伪随机生成器。
反证假设
采用反证法。
假设存在概率多项式时间算法 $A’$,可以预测 $G’(U_n)$ 中的下一位,即存在多项式 $\mathrm{poly}’(n)$ 使得对于无限多个 $n$ 成立:
那么,只需要构造算法 $A’’$,在给定 $f(U_n)$ 以不可忽略的高于 $\frac{1}{2}$ 的概率预测 $b(U_n)$ 即可得到矛盾。
具体来说,令算法 $A’’$ 输入 $y=f(x)\in\{0,1\}^{n}$,执行以下步骤:
- 随机选择 $j\in\{0,1,\cdots,t-1\}$
- 计算 $\alpha = b(f^{j-1}(y)) \cdots b(y)$,其中 $|\alpha|=j$
- 随机选择 $\beta\in\{0,1\}^{t-j}$
- 输入 $(1^t,\alpha\beta)$,调用 $A’$,并记录 $A’$ 读取输入前缀的长度 $l$、$A’$ 的输出 $\tau$
- 如果 $l=j$,输出 $\tau$,否则随机输出一个比特
前缀分布
当输入 $f(U_n)$ 时,对于任意选择的 $j$,算法 $A’’$ 计算
令 $y=f(U_n)$,则:
由于 $f$ 在 $\{0,1\}^{n}$ 上诱导一个置换,因此 $b(f^{j-1}(U_n)) \cdots b(U_n)$ 和 $b(f^{t-1}(U_n)) \cdots b(f^{t-j}(U_n))$ 具有相同分布。而后者正是 $G’(U_n)$ 的前 $j$ 位。
因此,$\alpha$ 和 $G’(U_n)$ 的前 $j$ 位分布一致。
成功概率分析
令 $R_j(y)$ 是一个随机过程,给定输入 $y$,输出 $b(f^{j-1}(y)) \cdots b(y)\cdot r$,其中 $r$ 在 $\{0,1\}^{t-j}$ 中均匀分布。
令 $L_{A’}(\gamma)$ 表示算法 $A’$ 输入 $(1^t,\gamma)$ 时读取的前缀长度,由于 $A’$ 只依赖它读取的部分,因此 $\mathrm{next}_{A’}(\gamma)$ 等于第 $L_{A’}(\gamma)+1$ 位。
令 $J$ 表示算法 $A’’$ 中第一步随机选择的 $j$,$U_1$ 表示第五步中随机输出的比特。如果 $L_{A’}(\gamma)=J$,那么 $A’’$ 输出 $A’(1^t,\gamma)$,否则输出随机比特。
因此,有:
由于 $R_J(f(U_n))$ 的前 $J$ 位与 $G’(U_n)$ 的前 $J$ 位分布相同,因此上式可化简为:
考虑到事件 $A’(1^t,G’(U_n)) = \mathrm{next}_{A’}(G’(U_n))$ 与 $J$ 独立,因此对于上式中的第一项,有:
进一步,假设 $A’$ 不会读取全部 $t$ 位输入。因此:
而 $J$ 均匀随机选择 $0,\cdots,t-1$,所以有:
因此,成功概率可化简为:
将 $t=\mathrm{poly}(n)$ 与反证假设代入,有:
矛盾推出
因此,算法 $A’’$ 可以根据 $f(U_n)$ 预测 $b(U_n)$,成功概率为至少为 $\frac{1}{2}+ \frac{1}{\mathrm{poly}(n)\mathrm{poly}’(n)}$,即比随机猜测 $\frac{1}{2}$ 高出不可忽略优势。
但是,根据假设 $b$ 是 $f$ 的硬核谓词,任何多项式时间算法都不能做到这一点。
产生矛盾。因此,不存在预测算法 $A’$,所以 $G’(U_n)$ 不可预测。
而 $G’$ 是伪随机生成器,且 $G$ 和 $G’$ 只是输出顺序不同。因此,$G$ 也是伪随机生成器。